NCM คืออะไร และทำไมจึงถูกจับตามองว่าอาจเป็นอนาคตของวงการ AI? งานวิจัยจาก Stanford นำเสนอวิธีสร้างข้อความจากภาพรวมไปสู่รายละเอียด โดยรายงานว่าสร้างข้อความได้เร็วกว่า AI แบบ Diffusion บางรุ่นถึง 31 เท่า แต่ความเร็วที่เพิ่มขึ้นนี้จะทำให้ NCM เข้ามาแทนที่ LLM อย่าง ChatGPT และ Gemini ได้จริงหรือไม่?
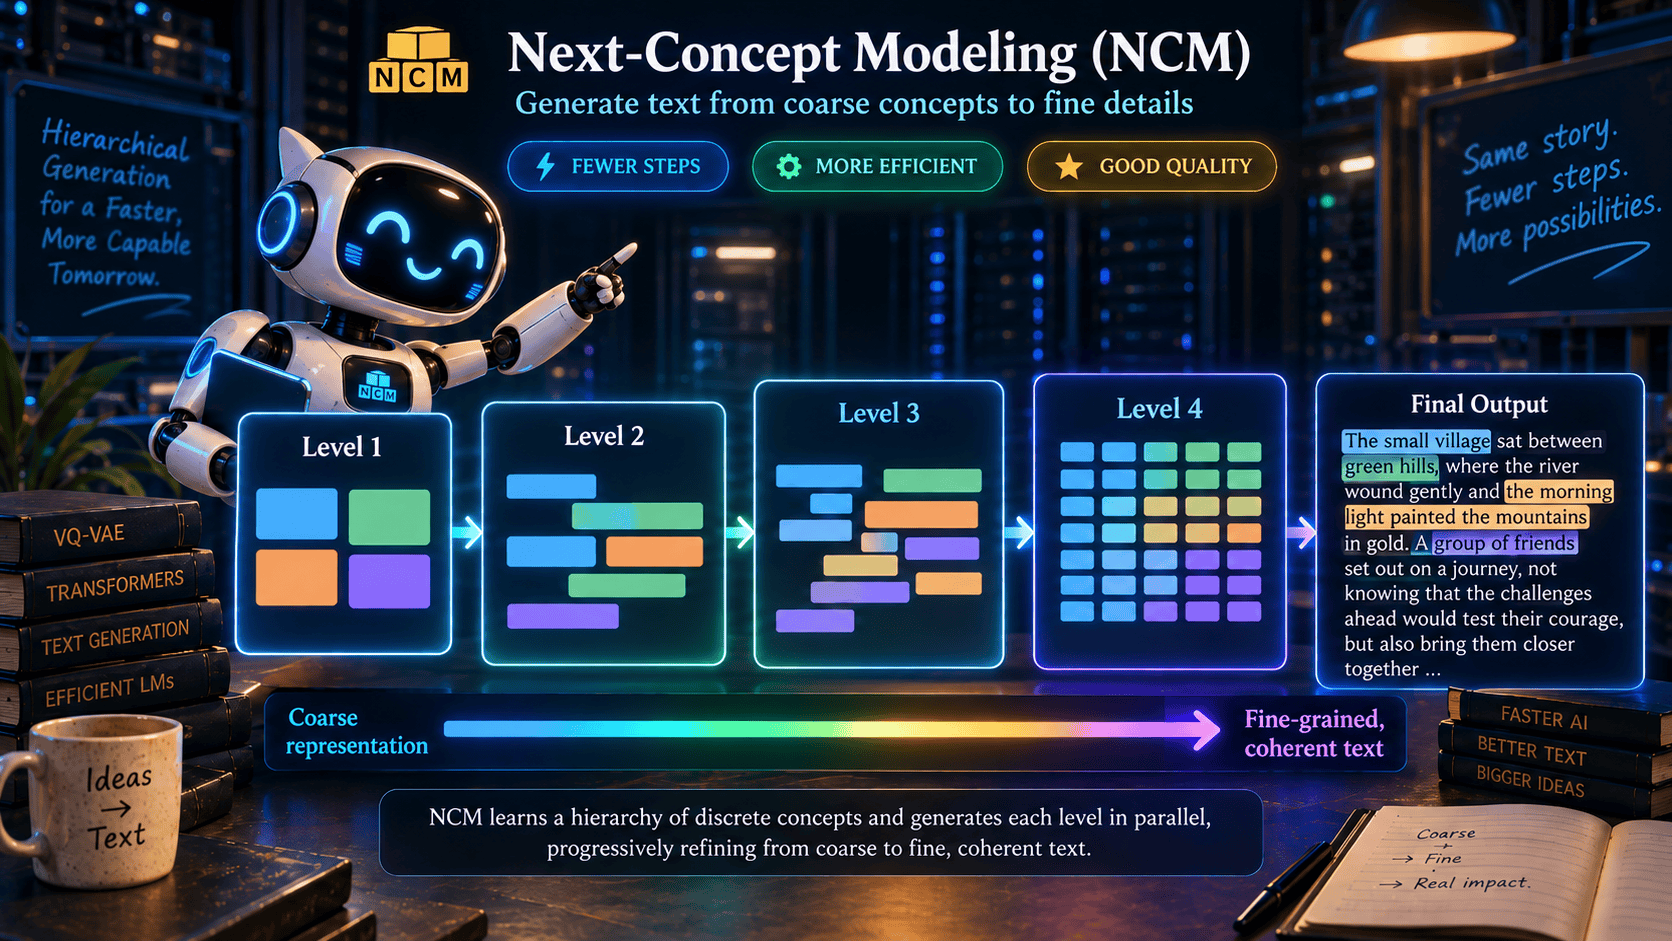
ปัจจุบัน AI อย่าง ChatGPT และ Gemini สามารถเขียนบทความ สรุปข้อมูล และตอบคำถามได้อย่างรวดเร็ว แต่เบื้องหลังการทำงานของโมเดลภาษาส่วนใหญ่ยังอาศัยการทำนายโทเคนถัดไปทีละตัว ซึ่งหมายความว่า โทเคนถัดไปต้องรอให้โทเคนก่อนหน้าถูกสร้างขึ้นมาก่อน
แต่จะเกิดอะไรขึ้น ถ้า AI สามารถสร้างข้อความโดยเริ่มจากภาพรวมก่อน แล้วค่อยเติมรายละเอียดหลายส่วนพร้อมกันได้?
นี่คือแนวคิดของ NCM (Next-Concept Modeling) งานวิจัยจากทีม Hazy Research ของมหาวิทยาลัย Stanford ซึ่งเผยแพร่เมื่อวันที่ 12 ตุลาคม 2026 โดยรายงานผลการทดลองว่า NCM สามารถสร้างข้อความได้เร็วกว่าโมเดล Diffusion Language Model บางรุ่นถึง 10–31 เท่า โดยยังรักษาคุณภาพผลลัพธ์ให้อยู่ในระดับใกล้เคียงกันในงานทดสอบบางประเภท
ตัวเลขนี้ทำให้ NCM กลายเป็นอีกหนึ่งแนวทางที่น่าจับตาในวงการ AI แต่ก่อนจะสรุปว่าเทคโนโลยีนี้จะเข้ามาแทนที่ LLM เราต้องทำความเข้าใจก่อนว่ามันทำงานอย่างไร และผลการทดลองดังกล่าวบอกอะไรเราได้บ้าง
NCM คืออะไร? AI ที่สร้างข้อความจากภาพรวมไปสู่รายละเอียด
NCM ย่อมาจาก Next-Concept Modeling เป็นแนวทางการสร้างข้อความที่ใช้ตัวแทนข้อมูลหลายระดับ โดยเริ่มจากข้อมูลระดับหยาบที่เก็บโครงสร้างหรือใจความโดยรวม แล้วค่อยเพิ่มรายละเอียดในระดับที่ละเอียดขึ้นตามลำดับ
เพื่อให้เห็นภาพ ลองเปรียบเทียบกับการเขียนบทความของมนุษย์ หากต้องเขียนบทความหนึ่งชิ้น เราอาจเริ่มจากกำหนดประเด็นหลัก วางโครงสร้างแต่ละย่อหน้า แล้วจึงเติมรายละเอียด ตัวอย่าง และคำอธิบายให้สมบูรณ์
NCM ใช้แนวคิดที่คล้ายกันในแง่ของการสร้างจากหยาบไปละเอียด แต่ไม่ได้หมายความว่า AI คิดหรือวางแผนเหมือนมนุษย์ทุกประการ เพราะเบื้องหลังเป็นกระบวนการเรียนรู้และสร้างตัวแทนข้อมูลทางคณิตศาสตร์
ความแตกต่างสำคัญอยู่ที่วิธีสร้างข้อความ โดย LLM แบบทั่วไปจะทำนายโทเคนถัดไปทีละตัว ขณะที่ NCM สร้างรหัสตัวแทนข้อมูลเป็นลำดับชั้น และสามารถทำนายรหัสหลายตำแหน่งภายในระดับเดียวกันพร้อมกันได้
NCM ทำงานอย่างไร? ทำไมจึงสร้างข้อความได้เร็วขึ้น
NCM แบ่งกระบวนการหลักออกเป็น 2 ขั้นตอน
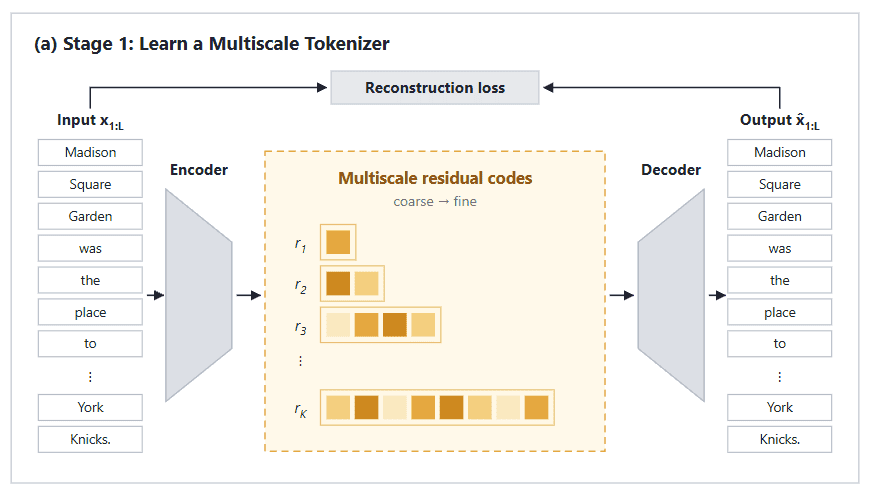
ขั้นตอนที่ 1: แปลงข้อความเป็นตัวแทนข้อมูลหลายระดับ
ระบบใช้โมเดลประเภท Multiscale Residual VQ-VAE เพื่อแปลงข้อความให้เป็นรหัสข้อมูลที่มีหลายระดับ ตั้งแต่ระดับหยาบไปจนถึงระดับละเอียด โดยแต่ละระดับจะช่วยเพิ่มข้อมูลจากระดับก่อนหน้า
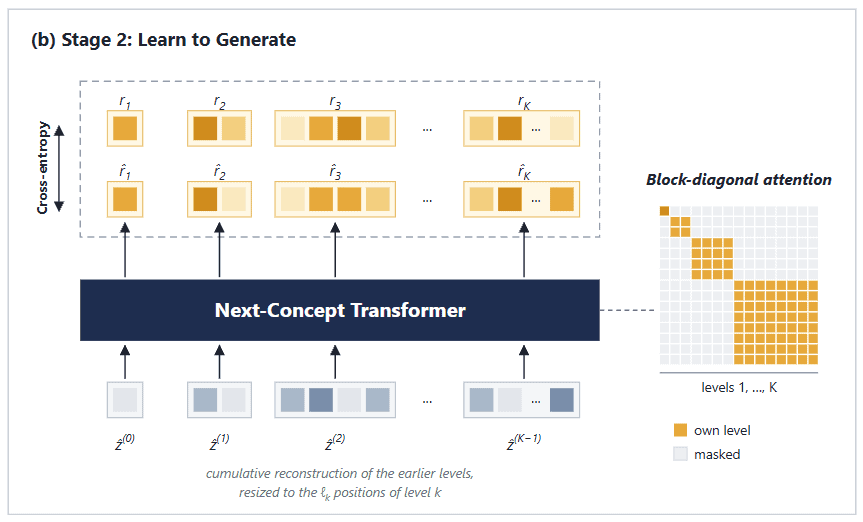
ขั้นตอนที่ 2: สร้างรหัสข้อมูลจากหยาบไปละเอียด
จากนั้น Transformer จะสร้างรหัสข้อมูลทีละระดับ โดยทำนายรหัสทั้งหมดภายในระดับนั้นพร้อมกัน เมื่อสร้างครบทุกระดับแล้ว ระบบจึงถอดรหัสกลับมาเป็นข้อความ
วิธีนี้ช่วยลดจำนวนขั้นตอนที่ต้องใช้ในการสร้างผลลัพธ์ เมื่อเทียบกับวิธีที่ต้องสร้างโทเคนทีละตัว หรือวิธี Diffusion ที่ต้องปรับปรุงข้อความซ้ำหลายรอบ
อย่างไรก็ตาม NCM ไม่ได้สร้างทุกอย่างพร้อมกันในครั้งเดียว เพราะยังต้องสร้างข้อมูลเรียงตามระดับจากหยาบไปละเอียด เพียงแต่สามารถประมวลผลหลายตำแหน่งพร้อมกันภายในแต่ละระดับได้
NCM เร็วขึ้น 31 เท่าจริงหรือ? ผลทดลองพบอะไรบ้าง
งานวิจัยของทีม Stanford ทดสอบ NCM กับชุดข้อมูลมาตรฐานหลายชุด และเปรียบเทียบกับโมเดล Diffusion Language Model โดยวัดทั้งความเร็วและคุณภาพของข้อความที่สร้างขึ้น ผลที่รายงานมีดังนี้
- เร็วขึ้น 21 เท่า: ในชุดข้อมูล LM1B โดย NCM ทำคะแนนด้านคุณภาพการสร้างข้อความได้ดีกว่าโมเดล Diffusion ที่แข็งแกร่งที่สุดในกลุ่มเปรียบเทียบ
- เร็วขึ้น 10 เท่า: ในชุดข้อมูล OpenWebText โดยให้คุณภาพการสร้างข้อความใกล้เคียงกับโมเดล Diffusion ที่ใช้เปรียบเทียบ
- เร็วขึ้น 31 เท่า: ในงานสรุปข่าว XSum โดยได้คะแนน ROUGE-L ใกล้เคียงกับโมเดล Diffusion ที่แข็งแกร่งที่สุดในกลุ่มเปรียบเทียบ
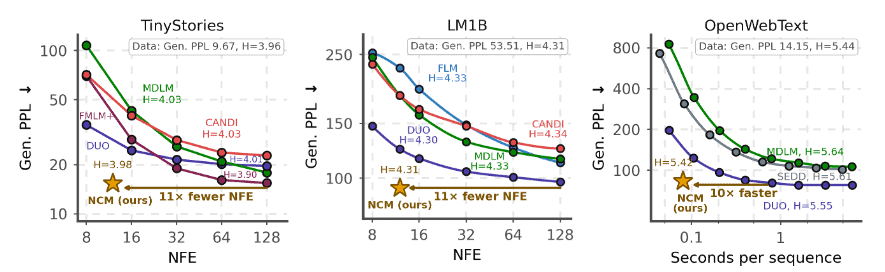
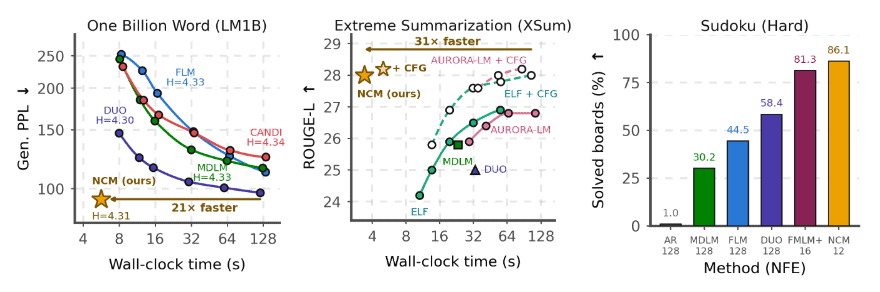
การทดสอบความเร็วใช้ GPU NVIDIA H100 SXM ขนาดหน่วยความจำ 80GB จำนวนหนึ่งตัว โดยวัดเวลาสร้างข้อความภายใต้เงื่อนไขการทดลองที่กำหนด
นอกจากความเร็วแล้ว ทีมวิจัยยังรายงานว่า NCM ใช้โทเคนฝึกน้อยกว่าโมเดล Diffusion ที่ใช้เปรียบเทียบประมาณ 4.9 เท่าใน LM1B และ 4 เท่าใน OpenWebText เมื่อรวมข้อมูลที่ใช้ฝึกทั้งส่วนแปลงข้อมูลและส่วนสร้างข้อความ
ตัวเลขเหล่านี้จึงสะท้อนว่า NCM อาจเพิ่มประสิทธิภาพได้ทั้งในขั้นตอนการฝึกและการสร้างข้อความ แต่ยังต้องระวังการตีความ เพราะผลลัพธ์ดังกล่าวมาจากการทดลองกับชุดข้อมูลและโมเดลที่กำหนด ไม่ใช่การเปรียบเทียบกับ AI เชิงพาณิชย์ทุกประเภท
ไม่ได้มีดีแค่ความเร็ว NCM ยังทดสอบงานใช้เหตุผลด้วย
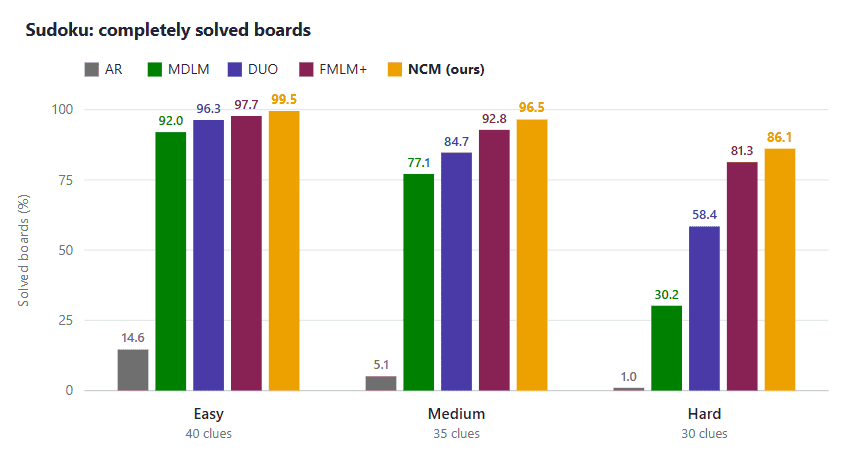
อีกหนึ่งผลการทดลองที่น่าสนใจคือการใช้ NCM แก้โจทย์ Sudoku ซึ่งเป็นเกมตัวเลขที่ต้องจัดวางตัวเลขให้สอดคล้องกับเงื่อนไขของแถว คอลัมน์ และกล่องย่อยทั้งหมด
ในโจทย์ระดับยากที่กำหนดตัวเลขเริ่มต้นไว้ 30 ช่อง งานวิจัยรายงานว่า NCM แก้กระดานได้สำเร็จ 86.1% เทียบกับโมเดล Diffusion ที่แข็งแกร่งที่สุดในกลุ่มเปรียบเทียบ ซึ่งทำได้ 81.3% ขณะที่โมเดล Autoregressive ในการทดลองเดียวกันทำได้ 1.0% โดย NCM ใช้จำนวนการประเมินโมเดลน้อยกว่าคู่เปรียบเทียบด้วย
ผลดังกล่าวชี้ให้เห็นว่าแนวทางสร้างข้อมูลจากหยาบไปละเอียดอาจมีประโยชน์กับงานที่ผลลัพธ์หลายส่วนต้องสอดคล้องกัน ไม่ได้จำกัดอยู่แค่การสร้างข้อความธรรมดา
อย่างไรก็ตาม การแก้ Sudoku สำเร็จไม่ได้ยืนยันว่า NCM มีความสามารถในการใช้เหตุผลเหนือกว่า LLM ทุกด้าน เพราะการทดลองนี้ครอบคลุมเพียงโจทย์และเงื่อนไขที่กำหนดเท่านั้น
แล้ว NCM จะฆ่า LLM หรือไม่?
แม้ตัวเลขความเร็วจะน่าตื่นเต้น แต่คำตอบในตอนนี้คือ ยังไม่มีหลักฐานเพียงพอที่จะสรุปว่า NCM จะเข้ามาแทนที่ LLM อย่าง ChatGPT หรือ Gemini ได้ทั้งหมด ด้วยเหตุผลสำคัญ 3 ประการ
1 ผลทดสอบความเร็วไม่ได้เปรียบเทียบกับ ChatGPT หรือ Gemini โดยตรง
ตัวเลข 10–31 เท่ามาจากการเปรียบเทียบกับโมเดล Diffusion Language Model ไม่ใช่การเปรียบเทียบกับระบบ AI เชิงพาณิชย์ระดับแนวหน้าโดยตรง จึงไม่ควรนำตัวเลขดังกล่าวไปสรุปว่า NCM ตอบคำถามเร็วกว่า ChatGPT 31 เท่า
2 โมเดลที่ทดลองยังมีขนาดค่อนข้างเล็ก
การทดลองหลักใช้โมเดลในระดับประมาณ 100 ล้านพารามิเตอร์ ซึ่งเล็กกว่าโมเดลภาษาขนาดใหญ่จำนวนมากที่ใช้ในระบบเชิงพาณิชย์ แม้งานวิจัยจะมีการทดลองขยายขนาดเบื้องต้น แต่ยังต้องพิสูจน์ว่าประสิทธิภาพจะคงอยู่เมื่อเพิ่มขนาดโมเดล ข้อมูล และกำลังประมวลผล
3 ยังต้องพิสูจน์กับงานจริงที่หลากหลาย
การนำ AI ไปใช้งานจริงไม่ได้วัดแค่ความเร็วในการสร้างข้อความ แต่ยังต้องพิจารณาความถูกต้อง การทำตามคำสั่ง การเขียนโค้ด การใช้เครื่องมือ และความสามารถในการจัดการโจทย์ที่ซับซ้อนด้วย
ดังนั้น NCM จึงควรถูกมองว่าเป็นอีกแนวทางหนึ่งในการพัฒนาโมเดลภาษา มากกว่าจะเป็นเทคโนโลยีที่กำลังจะทำให้ LLM หมดความสำคัญในทันที
ถ้า NCM พัฒนาต่อสำเร็จ อนาคตของ AI อาจเปลี่ยนไปอย่างไร
หากทีมวิจัยสามารถขยายขนาด NCM และรักษาคุณภาพของผลลัพธ์ไว้ได้ เทคโนโลยีนี้อาจสร้างผลกระทบได้หลายด้าน
- AI ตอบสนองได้รวดเร็วขึ้น: โดยเฉพาะงานที่ต้องสร้างข้อความจำนวนมาก เช่น การสรุปเอกสาร การแปลภาษา และการสร้างเนื้อหา
- อาจช่วยลดต้นทุนการประมวลผล: หากใช้ทรัพยากรน้อยลงในการสร้างผลลัพธ์ที่มีคุณภาพใกล้เคียงกัน ผู้ให้บริการอาจรองรับคำขอได้มากขึ้นภายใต้งบประมาณเท่าเดิม
- สร้างคำตอบหลายชุดเพื่อเลือกคำตอบที่ดีขึ้น: ความเร็วที่เพิ่มขึ้นอาจทำให้ระบบสามารถสร้างตัวเลือกหลายชุดและคัดเลือกผลลัพธ์ที่เหมาะสมที่สุดได้ภายในเวลาที่จำกัด
ทั้งสามข้อยังเป็นโอกาสที่ต้องพิสูจน์เพิ่มเติม ไม่ใช่ผลลัพธ์ที่ยืนยันแล้วสำหรับระบบ AI ขนาดใหญ่ในปัจจุบัน โดยทีมวิจัยเองก็ระบุว่าการขยายขนาดโมเดล การเรียนรู้ตัวแทนข้อมูลร่วมกับการสร้างข้อความ และการปรับการประมวลผลตามความยากของโจทย์ เป็นทิศทางสำคัญสำหรับงานต่อไป
สรุป NCM อาจไม่ฆ่า LLM แต่กำลังท้าทายวิธีที่ AI สร้างข้อความ
NCM แสดงให้เห็นว่า AI อาจไม่จำเป็นต้องสร้างข้อความทีละโทเคนเสมอไป การสร้างตัวแทนข้อมูลจากภาพรวมไปสู่รายละเอียดและการทำนายหลายตำแหน่งพร้อมกัน อาจช่วยลดจำนวนขั้นตอนและเพิ่มความเร็วได้อย่างมากในงานบางประเภท
ผลการทดลองที่เร็วขึ้น 10–31 เท่าเมื่อเทียบกับโมเดล Diffusion เป็นสัญญาณที่น่าสนใจ แต่ยังไม่ใช่หลักฐานว่า NCM จะมาแทนที่ ChatGPT หรือ Gemini ได้โดยตรง
สิ่งที่ควรจับตาต่อจากนี้จึงไม่ใช่แค่ว่า NCM จะฆ่า LLM ได้หรือไม่ แต่คือ แนวทางการสร้างข้อความแบบใหม่นี้จะขยายไปสู่โมเดลขนาดใหญ่ได้แค่ไหน โดยยังรักษาคุณภาพ ความถูกต้อง และต้นทุนที่ได้เปรียบไว้ได้หรือไม่
หากทำได้สำเร็จ NCM อาจกลายเป็นหนึ่งในแนวทางสำคัญที่ช่วยให้ AI ในอนาคตสร้างคำตอบได้เร็วขึ้นและใช้ทรัพยากรได้อย่างมีประสิทธิภาพมากขึ้น
อ้างอิง hazyresearch.stanford.edu arxiv.org github.com cover iT24Hrs
และข่าวอื่นๆเพิ่มเติมได้ที่ it24hrs.com
NCM คืออะไร จะฆ่า LLM หรือไม่? ทำไมคนถึงมองว่าเป็นอนาคตของวงการ AI
อย่าลืมกดติดตามอัพเดตข่าวสาร ทิปเทคนิคดีๆกันนะคะ Please follow us
Youtube it24hrs
Twitter it24hrs
Tiktok it24hrs
facebook it24hrs
ติดต่อโฆษณา [email protected] โทร 080234502