Jev คืออะไร? AI ยุคใหม่อาจไม่ต้อง “พูดเก่ง” แต่ต้องตัดสินใจให้ซอฟต์แวร์ได้ทันที Jev จึงเป็นโมเดลที่ไม่เน้นสร้างข้อความ แต่เน้นที่การส่งคำตอบแบบมีโครงสร้างและค่าความมั่นใจให้ระบบนำไปทำงานต่อ จาก AI ที่เคยตอบคำถามมนุษย์ กำลังเปลี่ยนไปสู่ AI ที่ ตัดสินใจแทนซอฟต์แวร์ ได้อย่างรวดเร็วและต้นทุนต่ำ
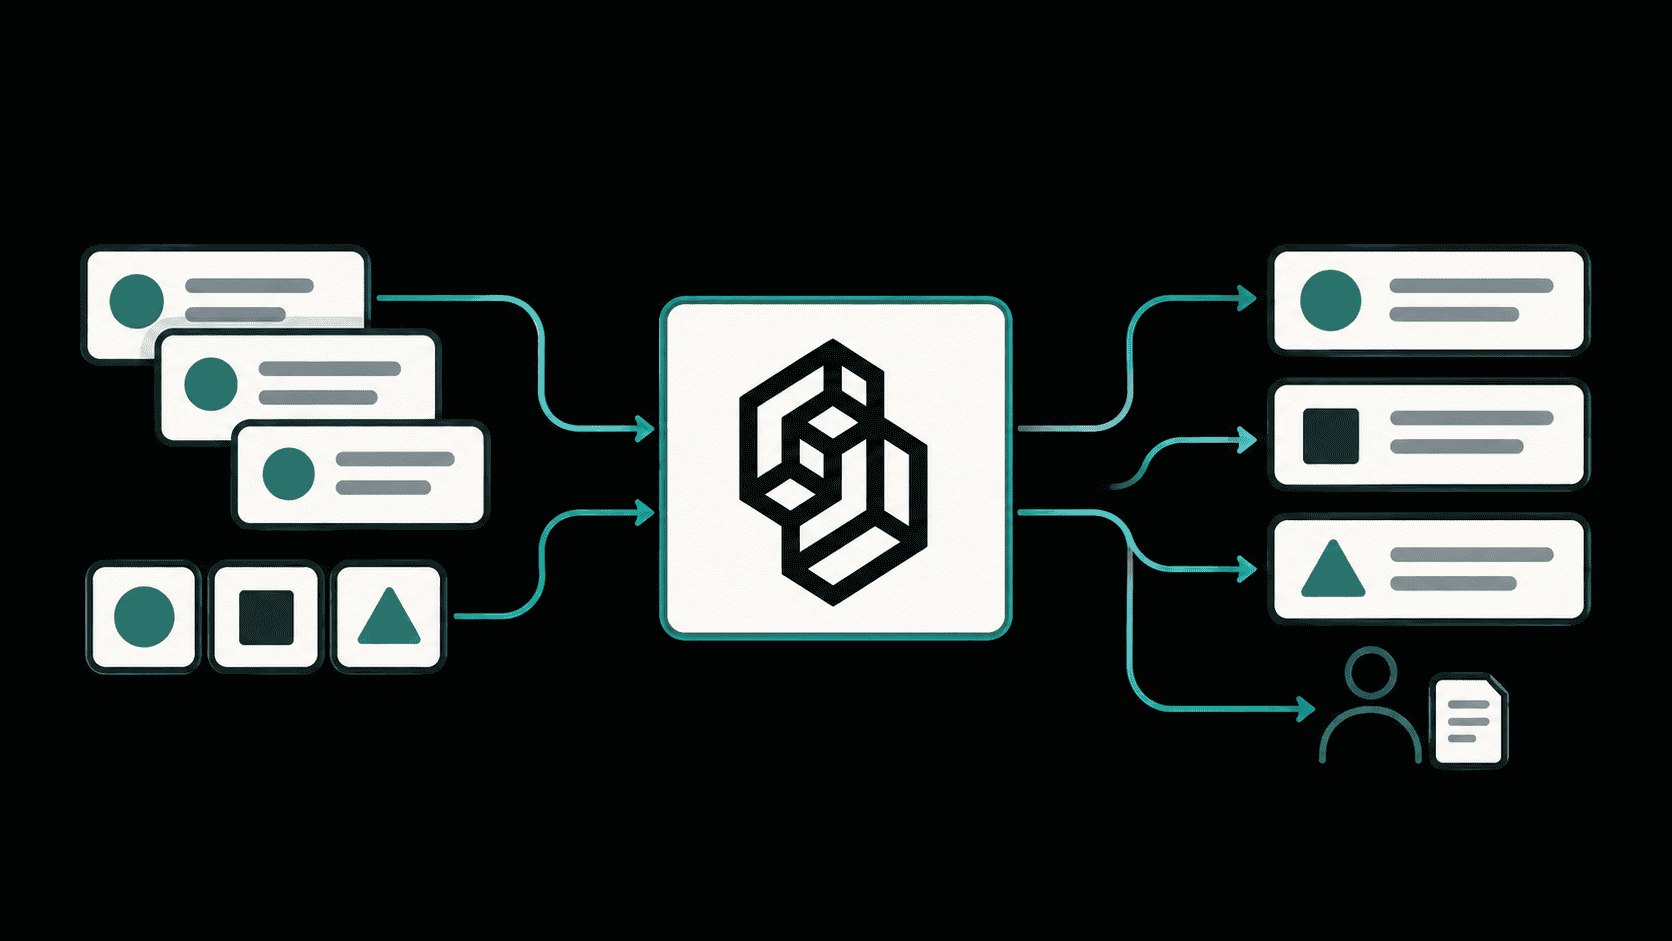
Jev คืออะไร? AI ที่อ่านข้อมูลแล้วตัดสินใจว่าระบบควรทำอะไรต่อ
ถ้า AI ยุคปัจจุบันอย่าง ChatGPT หรือ Claude ถูกออกแบบมาให้ “พูดคุยกับมนุษย์” แต่ Jev จากบริษัท TypeSafe AI กำลังเสนอแนวคิดที่แตกต่างออกไป นั่นคือการสร้าง AI ที่ไม่ได้มีเป้าหมายหลักในการเขียนคำตอบยาว ๆ หรือสร้างข้อความที่อ่านเข้าใจง่ายสำหรับมนุษย์ Jev ถูกออกแบบมาเพื่อเป็นกลไกการตัดสินใจที่อยู่ภายในซอฟต์แวร์ โดยรับข้อมูลหรือสถานะของระบบเข้ามา แล้วประเมินว่าควรดำเนินการอย่างไรต่อ จากนั้นส่งผลลัพธ์กลับไปในรูปแบบที่โปรแกรมสามารถนำไปใช้ได้โดยตรง TypeSafe เรียกสถาปัตยกรรมแนวคิดนี้ว่า System One Model และอธิบายว่า Jev เป็น “frontier-intelligence function call” หรือมองง่าย ๆ ว่าเป็นฟังก์ชันอัจฉริยะที่รับข้อมูลที่ไม่มีโครงสร้างเข้ามา แล้วคืนค่าการตัดสินใจที่มีโครงสร้างและมีความน่าจะเป็นกำกับอยู่
แนวคิดนี้เกิดจากข้อสังเกตว่า แม้ LLM จะมีความสามารถในการทำความเข้าใจภาษาและปฏิบัติตามคำสั่งได้อย่างก้าวหน้า แต่ซอฟต์แวร์จำนวนมากไม่ได้ต้องการคำตอบเป็นย่อหน้า สิ่งที่โปรแกรมต้องการอาจเป็นเพียงการตัดสินใจสั้น ๆ เช่น “อนุมัติหรือไม่”, “เร่งด่วนหรือไม่”, “ส่งไปฝ่ายใด”, “ควรบล็อกหรือปล่อยผ่าน” หรือ “ควรให้ AI อีกตัวตรวจสอบต่อหรือไม่” TypeSafe จึงพยายามสร้างโมเดลที่ทำหน้าที่ตรงกับงานลักษณะนี้ตั้งแต่ระดับสถาปัตยกรรม โดยกำหนดตัวเลือกและรูปแบบผลลัพธ์เอาไว้ล่วงหน้า ทำให้ Jev สามารถทำหน้าที่คล้ายกับ “สมองสำหรับ if-then” ที่อยู่ภายในระบบมากกว่าจะเป็น chatbot ที่รอให้มนุษย์เข้ามาสนทนา
ตัวอย่างเช่น ระบบบริการลูกค้าอาจส่งข้อความว่า “ช่วยด้วย การจ่ายเงินของฉันล้มเหลวมาสามวันแล้ว” ให้ Jev วิเคราะห์ แล้วกำหนดคำถามให้โมเดลตอบ เช่น ลูกค้ากำลังแสดงความเร่งด่วนหรือไม่ ควรส่งเรื่องไปฝ่าย Billing หรือ Technical และลูกค้ามีระดับความไม่พอใจอยู่ในระดับใด ผลลัพธ์ที่ได้จึงไม่จำเป็นต้องเป็นประโยคอย่าง “ดูเหมือนว่าลูกค้ารายนี้มีปัญหาด้านการชำระเงินและควรได้รับการช่วยเหลือโดยเร็ว” แต่สามารถกลายเป็นค่าที่โปรแกรมนำไปทำงานต่อได้ทันที เช่น urgent = true, department = billing หรือคะแนนความไม่พอใจพร้อมค่าความน่าจะเป็น
Jev ส่งผลการตัดสินใจที่เป็นโครงสร้างพร้อมค่าความมั่นใจ
ความแตกต่างสำคัญของ Jev จึงอยู่ที่ “รูปแบบของคำตอบ” มากกว่าการพยายามแข่งขันกันว่าใครสามารถเขียนข้อความได้สวยกว่า LLM ทั่วไปทำงานแบบการสร้างข้อความต่อเนื่อง โดยโมเดลสร้าง token ทีละส่วนและนำสิ่งที่สร้างก่อนหน้ามาใช้เป็นบริบทในการสร้างส่วนถัดไป ขณะที่ TypeSafe ระบุว่า Jev ถูกออกแบบให้ส่งออกค่าที่มีโครงสร้างตามประเภทที่กำหนดไว้ล่วงหน้า และสามารถประเมินคำตอบหลายส่วนในลักษณะขนานกันได้
ตัวอย่างจากเอกสารของ Cloudflare ซึ่งให้บริการ Jev ในรูปแบบโมเดล typesafe/jev แสดงให้เห็นแนวคิดนี้อย่างชัดเจน โดยคำถามหนึ่งอาจเป็นคำถามแบบเลือกคำตอบ เช่น ควรส่งงานไปฝ่าย Billing, Technical หรือ Sales จากนั้น Jev ไม่ได้เขียนคำอธิบายยาว ๆ แต่ส่งคำตอบว่าเลือก Billing พร้อมความน่าจะเป็นของแต่ละตัวเลือก เช่น Billing 0.87 และ Technical 0.13 รวมถึงค่าความมั่นใจของการตัดสินใจ ขณะเดียวกันคำถามแบบคะแนนก็สามารถคืนทั้งคะแนน ความน่าจะเป็นของแต่ละระดับ และ confidence ได้เช่นกัน
จุดนี้ทำให้ “ความไม่แน่นอน” กลายเป็นข้อมูลที่ซอฟต์แวร์สามารถนำไปใช้ได้โดยตรง สมมติระบบต้องตัดสินใจว่าจะอนุมัติคำขอหรือส่งให้มนุษย์ตรวจสอบ เราอาจกำหนดกฎว่า หาก Jev มีความมั่นใจสูงกว่าเกณฑ์ที่กำหนด ให้ระบบดำเนินการต่ออัตโนมัติ แต่ถ้าความมั่นใจต่ำกว่านั้น ให้ส่งเรื่องไปยังเจ้าหน้าที่หรือโมเดลที่มีความสามารถสูงกว่า แนวทางดังกล่าวทำให้ AI ไม่ได้ถูกมองว่าเป็นเพียงเครื่องสร้างคำตอบ แต่เป็นส่วนหนึ่งของ workflow ที่สามารถกำหนดกติกาการทำงานรอบ ๆ การตัดสินใจของโมเดลได้
อย่างไรก็ตาม คำว่า “confidence” ไม่ควรถูกตีความว่าเป็นใบรับรองความถูกต้องของคำตอบ เพราะความมั่นใจเป็นค่าที่โมเดลประเมินขึ้นมาเพื่อสะท้อนระดับความเชื่อมั่นของการตัดสินใจ ไม่ได้หมายความว่าคำตอบนั้นถูกต้องตามความเป็นจริงเสมอไป และงานวิจัยที่ศึกษาการใช้ Jev เป็นผู้ตัดสินก็พบว่าความผิดพลาดยังเกิดขึ้นได้ แม้โมเดลจะสามารถจัดอันดับความมั่นใจของข้อผิดพลาดบางประเภทได้ก็ตาม
Jev ใช้การประมวลผลแบบขนาน จึงตัดสินใจได้รวดเร็วและต้นทุนต่ำ
เหตุผลที่ Jev ถูกวางตำแหน่งให้เหมาะกับงานอัตโนมัติจำนวนมากมาจากการตัดสิ่งที่ไม่จำเป็นสำหรับงานประเภท “ตัดสินใจ” ออกไป นั่นคือการสร้างข้อความแบบอิสระ หากระบบต้องการเพียงคำตอบว่า “ผ่าน”, “ไม่ผ่าน” หรือ “ส่งตรวจสอบ” การให้โมเดลสร้างย่อหน้าคำอธิบายก่อนที่โปรแกรมจะต้องนำคำตอบนั้นไปตีความอีกครั้ง อาจเป็นกระบวนการที่เกินความจำเป็น TypeSafe จึงออกแบบ Jev ให้สร้างผลลัพธ์ที่มีประเภทและโครงสร้างชัดเจน พร้อมระบุว่าโมเดลใช้ parallel sampler เพื่อประสิทธิภาพ และให้ผลลัพธ์หลายส่วนภายใน query เดียวแทนการสร้างข้อความทีละ token แบบ autoregressive
TypeSafe ระบุว่า Jev มีเวลาในการตอบสนองประมาณ 70–500 มิลลิวินาทีในสภาพแวดล้อมที่บริษัททดสอบ และอ้างว่าสำหรับงานในกลุ่ม System One บางประเภท Jev สามารถทำงานได้เร็วกว่าและมีต้นทุนต่ำกว่า LLM ทั่วไปอย่างมาก โดยหน้าเว็บไซต์ของบริษัทระบุการเปรียบเทียบหนึ่งว่า Jev มีต้นทุนประมาณ 0.000081 ดอลลาร์และใช้เวลา 0.114 วินาที เทียบกับระบบ LLM ที่นำมาเปรียบเทียบซึ่งมีต้นทุน 0.013880 ดอลลาร์และใช้เวลา 8.566 วินาที อย่างไรก็ตาม ตัวเลขเหล่านี้เป็นผลการทดสอบและการเปรียบเทียบที่ TypeSafe จัดทำขึ้นเอง จึงควรอ่านในฐานะข้อมูลจากผู้พัฒนา ไม่ใช่ข้อสรุปว่า Jev จะเร็วหรือถูกกว่า LLM ทุกกรณี
ประโยชน์จึงน่าสนใจเป็นพิเศษในงานที่มีจำนวนการเรียกใช้มหาศาล เช่น การคัดกรองเอกสาร การจัดประเภทคำขอ การตรวจสอบธุรกรรม การประเมินความเสี่ยง การจัดเส้นทางของ ticket หรือการตรวจสอบผลลัพธ์จากระบบ AI อื่น เพราะแม้การประหยัดเวลาเพียงไม่กี่ร้อยมิลลิวินาทีหรือประหยัดค่า inference เพียงเล็กน้อยต่อหนึ่งคำขอ เมื่อคูณกับคำขอนับล้านหรือพันล้านครั้ง ก็สามารถเปลี่ยนต้นทุนรวมของระบบได้อย่างมีนัยสำคัญ งานวิจัยที่เปรียบเทียบ Jev กับ LLM-as-a-judge ในเดือนกันยายน 2026 ก็พบว่าในชุดการทดลองของผู้วิจัย LLM judges มีต้นทุนสูงกว่า Jev ประมาณ 29–325 เท่า และใช้เวลานานกว่าประมาณ 30–220 เท่า แม้ความแม่นยำจะแตกต่างกันไปตามประเภทของเกณฑ์ที่ใช้ตัดสิน
ดังนั้น Jev จึงไม่ได้พยายามแทนที่ LLM ในทุกสถานการณ์ แต่กำลังชี้ไปยังพื้นที่ที่แตกต่างออกไป คือการนำ AI ไปใส่ไว้ในจุดเล็ก ๆ จำนวนมากของซอฟต์แวร์ ตั้งแต่ระบบหลังบ้านไปจนถึง workflow อัตโนมัติ ซึ่งแต่ละจุดอาจต้องตัดสินใจเพียงหนึ่งเรื่อง แต่ต้องตัดสินใจซ้ำแล้วซ้ำอีกในปริมาณมหาศาล แนวคิดของ TypeSafe คือเมื่อ “ต้นทุนต่อการตัดสินใจ” ลดลงมาก การนำ AI ไปใส่ในกระบวนการที่เดิมไม่คุ้มค่าทางเศรษฐกิจก็อาจกลายเป็นสิ่งที่ทำได้จริงมากขึ้น
คัดกรอง ตรวจสอบ เลือกว่าจะส่งงานไปยัง AI ตัวไหน
เมื่อ Jev ไม่ได้ถูกจำกัดอยู่กับการตอบคำถามของมนุษย์ แต่สามารถคืนค่าการตัดสินใจให้โปรแกรมนำไปใช้ต่อได้โดยตรง บทบาทที่น่าสนใจจึงอยู่ที่การเป็น “ชั้นควบคุม” ระหว่างข้อมูลกับระบบต่าง ๆ เช่น ระบบหนึ่งอาจใช้ Jev ตรวจสอบว่าข้อความเข้าข่าย spam หรือไม่ ระบบบริการลูกค้าอาจใช้เพื่อเลือกว่าจะส่ง ticket ไปยังฝ่ายใด หรือระบบที่ใช้ AI หลายตัวอาจให้ Jev ทำหน้าที่เป็นตัวคัดกรองก่อนตัดสินใจว่าจะใช้โมเดลใดประมวลผลต่อ TypeSafe เองระบุ use cases เช่น classify, route, score, extract และ branch รวมถึงการตรวจสอบหรือให้คะแนนผลลัพธ์ของ AI ตัวอื่นและตรวจจับ jailbreaks
แนวคิดนี้ทำให้เกิดโครงสร้างแบบ “AI หลายชั้น” ได้ ตัวอย่างเช่น เมื่อมีคำขอเข้ามา ระบบอาจให้ Jev ประเมินก่อนว่าคำขอนั้นง่ายหรือซับซ้อน หากเป็นคำถามทั่วไปและ Jev มีความมั่นใจสูง ระบบก็สามารถส่งต่อไปยังโมเดลราคาถูกหรือ workflow อัตโนมัติ แต่ถ้าเป็นกรณีที่ซับซ้อนหรือมีความมั่นใจต่ำ ก็สามารถส่งไปยัง LLM ที่มีความสามารถด้าน reasoning สูงกว่า หรือส่งต่อให้มนุษย์ตรวจสอบ แนวคิดลักษณะนี้เรียกว่า cascade และงานวิจัยล่าสุดเกี่ยวกับ Jev-as-a-judge พบว่าการใช้ Jev เป็นด่านแรกแล้วส่งกรณีที่ไม่มั่นใจไปยังโมเดลที่ใหญ่กว่า สามารถลดต้นทุนได้มากในชุดการทดลองของผู้วิจัย โดยบางการทดลองรักษาความแม่นยำไว้ได้ประมาณ 99% ของผู้ตัดสินที่ใช้เป็นตัวเปรียบเทียบ แต่ผลลัพธ์ขึ้นอยู่กับงานและ benchmark ที่ใช้
อีกตัวอย่างหนึ่งคือการใช้ Jev เป็นผู้ตรวจสอบ AI ตัวอื่น สมมติว่า LLM ตัวหนึ่งสร้างคำตอบเกี่ยวกับนโยบายบริษัท ระบบอาจไม่ได้เชื่อคำตอบนั้นทันที แต่ส่งทั้งคำถามและคำตอบให้ Jev ประเมินว่า “คำตอบนี้ผ่านเกณฑ์หรือไม่” หากมั่นใจสูงก็ปล่อยผ่าน หากมีความไม่แน่นอนก็ส่งต่อไปยังโมเดลที่ใหญ่กว่า หรือให้มนุษย์ตรวจสอบ แนวทางนี้น่าสนใจเพราะเปลี่ยน AI จาก “เครื่องมือที่ต้องตอบทุกอย่างด้วยตัวเอง” ให้กลายเป็นส่วนประกอบเล็ก ๆ ในระบบตัดสินใจขนาดใหญ่
อย่างไรก็ตาม งานวิจัยอีกชุดหนึ่งเตือนว่าการทำ cascade ไม่ได้แก้ปัญหาทั้งหมด เพราะหาก Jev และ LLM มีข้อผิดพลาดที่สัมพันธ์กัน การส่งเฉพาะคำตอบที่ Jev ไม่มั่นใจไปให้ LLM อาจไม่ได้เพิ่มความถูกต้องมากเท่าที่คาดไว้ งานวิจัย JEV vs. LLMs as Rubric Judges พบว่า LLM ที่นำมาเปรียบเทียบมีแนวโน้มทำผิดในหลายจุดเดียวกับ Jev และเมื่อจำลอง cascade จากข้อมูลการทดลอง ผลประโยชน์ด้านความแม่นยำเพิ่มขึ้นค่อนข้างจำกัดเมื่อเทียบกับการใช้ผู้ตัดสินเพียงตัวเดียว ดังนั้นจุดแข็งของ Jev จึงอาจอยู่ที่การเป็น “ชิ้นส่วนหนึ่งของระบบ” มากกว่าการเป็นผู้ตัดสินสุดท้ายในทุกสถานการณ์
ความมั่นใจไม่ได้แปลว่าถูกต้องเสมอไป
ประเด็นที่น่าสนใจที่สุดของ Jev ในเวลานี้อาจไม่ใช่เรื่องความเร็วหรือราคาถูก แต่เป็นคำถามเกี่ยวกับ “ความน่าเชื่อถือของการตัดสินใจ” เพราะการที่โมเดลส่งผลลัพธ์ออกมาในรูปแบบที่ถูกต้องตาม schema ไม่ได้หมายความว่ามันเข้าใจความหมายของตัวเลือกได้ถูกต้องเสมอไป งานวิจัยที่เผยแพร่ในเดือนกันยายน 2026 โดย Yu Sun และ Junhao Xu ศึกษา Jev รวมถึงโมเดลที่มีลักษณะคล้ายกัน และพบประเด็นสำคัญว่า type-safe ไม่ได้แปลว่า error-free หรือการที่คำตอบอยู่ในรูปแบบที่ถูกต้อง ไม่ได้เป็นหลักประกันว่าการตัดสินใจนั้นถูกต้องตามความหมายที่มนุษย์ตั้งใจไว้
งานวิจัยดังกล่าวทดลองโดยเปลี่ยนเฉพาะ “ชื่อของตัวเลือก” แต่คงคำถาม ข้อมูล และคำอธิบายเกณฑ์ของแต่ละตัวเลือกเอาไว้เหมือนเดิม ตัวอย่างเช่น เปลี่ยนชื่อจากตัวเลือกที่เป็นกลางอย่าง 0/1 ไปเป็นชื่อที่มีความหมายเชิงขั้วอย่าง no/yes แล้วสลับว่าชื่อใดผูกอยู่กับเกณฑ์ใด ผลการทดลองกับ Jev บน 1,200 การตัดสินใจพบว่าการเปลี่ยนชื่อจาก 0/1 เป็น no/yes ทำให้ผลการตัดสินใจเปลี่ยนอย่างมาก และค่า AUC ซึ่งใช้วัดความสามารถในการจัดอันดับการตัดสินใจก็เปลี่ยนจาก 0.94 เป็น 0.23 ในการทดลองนั้น ขณะที่อัตรา type error ยังคงเป็น 0%
ข้อค้นพบนี้มีความสำคัญมากสำหรับ AI ที่ถูกออกแบบมาให้ซอฟต์แวร์นำคำตอบไปใช้โดยตรง เพราะระบบอาจตรวจสอบได้อย่างสมบูรณ์แบบว่า AI ตอบกลับมาอยู่ในตัวเลือกที่อนุญาต แต่ระบบอาจไม่สามารถรู้ได้จากการตรวจ schema เพียงอย่างเดียวว่า AI เลือกตัวเลือกนั้นด้วยเหตุผลที่ถูกต้องหรือไม่ งานวิจัยจึงชี้ให้เห็นความแตกต่างระหว่าง “คำตอบถูกประเภท” กับ “คำตอบถูกความหมาย” ซึ่งเป็นปัญหาที่มีความสำคัญต่อระบบอัตโนมัติที่ต้องตัดสินใจโดยไม่ผ่านมนุษย์
ขณะเดียวกัน งานวิจัยอีกชิ้นที่เปรียบเทียบ Jev กับ LLM-as-a-judge พบว่า Jev สามารถทำผลงานใกล้เคียงกับ LLM ที่ใช้เป็นผู้ตัดสินในงานบางประเภท และมีข้อได้เปรียบด้านต้นทุนกับเวลาอย่างมาก แต่ก็พบช่องว่างที่ชัดเจนในงานที่ต้องตรวจสอบการอนุมานหรือรับมือกับคำตอบที่เขียนอย่างซับซ้อนและมีข้อมูลผิดแทรกอยู่ นอกจากนี้ แม้ confidence ของ Jev จะช่วยจัดอันดับข้อผิดพลาดได้ในหลายชุดการทดลอง แต่ข้อผิดพลาดที่มี confidence สูงก็ยังสามารถเกิดขึ้นได้
ดังนั้น Jev จึงน่าสนใจในฐานะตัวแทนของแนวคิดใหม่ในโลก AI นั่นคือ AI อาจไม่จำเป็นต้องพูดเก่งที่สุดเพื่อสร้างประโยชน์สูงสุดให้กับซอฟต์แวร์ แต่ในบางงาน สิ่งที่สำคัญกว่าอาจเป็นการตัดสินใจให้เร็ว ถูกโครงสร้าง ใช้ต้นทุนต่ำ และบอกระบบได้ว่าตัวเองมั่นใจแค่ไหน ขณะเดียวกัน การนำโมเดลลักษณะนี้ไปใช้ในงานจริงก็ต้องออกแบบระบบตรวจสอบเพิ่มเติม เพราะ confidence ไม่ใช่หลักประกันความถูกต้อง และความเป็น type-safe ไม่ได้ทำให้โมเดลเข้าใจความหมายของตัวเลือกได้ถูกต้องโดยอัตโนมัติ
ในมุมนี้ Jev จึงไม่ได้เป็นเพียง “AI ตัวใหม่ที่เร็วกว่า LLM” แต่เป็นการทดลองเปลี่ยนอินเทอร์เฟซระหว่าง AI กับซอฟต์แวร์ จากเดิมที่ซอฟต์แวร์ต้องรับ “ข้อความ” จาก AI แล้วพยายามตีความต่อ มาเป็นการที่ AI ส่ง “การตัดสินใจที่มีโครงสร้าง” ให้ซอฟต์แวร์นำไปใช้ทันที หากแนวทางนี้พิสูจน์ความน่าเชื่อถือได้มากขึ้น ก็อาจทำให้ AI ถูกฝังอยู่ในระบบหลังบ้านจำนวนมหาศาล โดยผู้ใช้อาจไม่เห็น chatbot หรือข้อความจาก AI เลยด้วยซ้ำ แต่ทุกครั้งที่ระบบต้องคัดกรอง จัดลำดับ เลือกเส้นทาง อนุมัติ ปฏิเสธ หรือส่งงานไปตรวจสอบเพิ่มเติม ก็อาจมีโมเดลประเภทนี้ทำหน้าที่เป็นกลไกตัดสินใจอยู่เบื้องหลัง
อ้างอิง typesafe.ai indianexpress.com และ cover iT24Hrs
และข่าวอื่นๆเพิ่มเติมได้ที่ it24hrs.com
Jev คืออะไร? AI รุ่นใหม่ที่เกิดมาเพื่อสั่งการซอฟต์แวร์
อย่าลืมกดติดตามอัพเดตข่าวสาร ทิปเทคนิคดีๆกันนะคะ Please follow us
Youtube it24hrs
Twitter it24hrs
Tiktok it24hrs
facebook it24hrs
ติดต่อโฆษณา [email protected] โทร 080234502