AI จับผิดคอนเทนต์ AI ได้อย่างไร? แค่บทความ รูปภาพ หรือวิดีโอที่โพสต์ลงโซเชียล ก็อาจถูกตรวจจับได้ว่าเป็นผลงานที่สร้างด้วย AI เบื้องหลังมีทั้งการวิเคราะห์รูปแบบภาษา ตรวจจับลายน้ำ และตรวจสอบข้อมูลแหล่งที่มาของไฟล์
วิเคราะห์ความน่าจะเป็นว่า คำถัดไปคาดเดาได้ง่ายแค่ไหน
หนึ่งในแนวทางที่ใช้ศึกษาว่าข้อความอาจสร้างขึ้นด้วย AI หรือไม่ คือการวิเคราะห์ว่าคำหรือส่วนของคำที่ปรากฏในข้อความนั้นคาดเดาได้ง่ายเพียงใด แนวคิดนี้เกี่ยวข้องกับค่าที่เรียกว่า Perplexity ซึ่งใช้วัดระดับความคาดเดาได้ของข้อความเมื่อเทียบกับโมเดลภาษาอ้างอิง โดยทั่วไป หากคำในข้อความเป็นคำที่โมเดลคาดการณ์ได้ง่าย ค่าดังกล่าวก็อาจต่ำลง แต่ถ้าข้อความมีการเลือกใช้คำหรือเรียงประโยคที่คาดเดาได้ยาก ค่าก็อาจสูงขึ้น ทั้งนี้ ค่าที่ได้ขึ้นอยู่กับโมเดลที่นำมาใช้วิเคราะห์ด้วย ไม่ใช่ค่าตายตัวที่ใช้ตัดสินข้อความทุกประเภทได้เหมือนกัน
ลองเปรียบเทียบประโยคสองแบบ ได้แก่
“กรุงเทพฯ เป็นเมืองที่มีความหลากหลายทางวัฒนธรรมและมีสถานที่ท่องเที่ยวที่น่าสนใจ”
“กรุงเทพฯ เป็นเมืองที่เดินไปไม่กี่ก้าวก็เจออะไรคนละโลก ทั้งวัดเก่า ร้านกาแฟ จนถึงตึกสำนักงาน”
ประโยคแรกมีโครงสร้างที่พบได้บ่อยในงานเขียนทั่วไป จึงอาจคาดเดาคำถัดไปได้ง่ายกว่าในบางโมเดล ส่วนประโยคที่สองมีสำนวนเปรียบเทียบและรายละเอียดเฉพาะตัวมากกว่า จึงอาจคาดเดาได้ยากกว่า อย่างไรก็ตาม ตัวอย่างนี้เป็นเพียงการอธิบายแนวคิด ไม่ใช่ผลการทดสอบจริง และไม่สามารถสรุปได้ว่าประโยคแรกเขียนด้วย AI ส่วนประโยคที่สองเขียนโดยมนุษย์ เพราะคนก็สามารถเขียนอย่างเป็นทางการและใช้สำนวนที่พบได้ทั่วไปได้เช่นกัน
ที่สำคัญ Perplexity ไม่ใช่เครื่องมือตรวจจับ AI โดยตัวมันเอง แต่เป็นหนึ่งในคุณสมบัติที่อาจนำไปใช้ประกอบการวิเคราะห์ข้อความได้ ระบบตรวจจับบางประเภทอาจนำคุณสมบัตินี้ไปใช้ร่วมกับสัญญาณอื่น ขณะที่บางระบบอาศัยโมเดลจำแนกข้อความที่เรียนรู้จากตัวอย่างงานเขียนของมนุษย์และ AI โดยตรง ดังนั้น หากบทความหนึ่งมีภาษาทางการ ใช้คำซ้ำ หรือมีโครงสร้างที่คาดเดาได้ง่าย ก็ไม่ควรรีบสรุปว่าเป็นผลงานจาก AI เพราะลักษณะดังกล่าวเกิดขึ้นได้กับงานข่าว หนังสือเรียน เอกสารราชการ และบทความ SEO ที่มนุษย์เขียนเช่นกัน
วิเคราะห์ความหลากหลายและรูปแบบการเขียน หรือ Burstiness
นอกจากการวิเคราะห์ความคาดเดาได้ของคำแล้ว อีกแนวคิดหนึ่งที่มักถูกพูดถึงคือ Burstiness ซึ่งใช้กล่าวถึงความแปรผันของลักษณะข้อความ เช่น ความยาวของประโยค ความซับซ้อนของโครงสร้าง และความเปลี่ยนแปลงของรูปแบบการเขียนภายในเนื้อหาเดียวกัน แนวคิดนี้ตั้งอยู่บนข้อสังเกตว่า งานเขียนบางชิ้นอาจมีทั้งประโยคสั้นที่ใช้เล่าเรื่องอย่างรวดเร็ว ประโยคยาวที่อธิบายรายละเอียด และประโยคที่มีสำนวนเฉพาะตัวสลับกันไป ขณะที่ข้อความบางประเภทอาจมีรูปแบบซ้ำ ๆ อย่างสม่ำเสมอ อย่างไรก็ตาม คำว่า Burstiness ไม่ได้หมายถึงค่ามาตรฐานเดียวที่ระบบตรวจจับ AI ทุกระบบใช้เหมือนกัน
ตัวอย่างเช่น ประโยคที่ว่า
“เมื่อวานผมไปกาญจนบุรีมา ฝนตกหนักมาก ตอนแรกคิดว่าจะไม่ได้ออกไปถ่ายรูปเล่นแล้ว แต่โชคดีมากเพราะตอนบ่ายฟ้าเปิดเฉยเลย”
มีทั้งประโยคสั้น ภาษาพูด และจังหวะการเล่าเรื่องที่เป็นธรรมชาติ ส่วนประโยค
“กาญจนบุรีเป็นจังหวัดที่มีความสำคัญทางประวัติศาสตร์ นอกจากนี้ยังมีความสำคัญทางวัฒนธรรม อีกทั้งยังเป็นสถานที่ท่องเที่ยวที่ได้รับความนิยมจากนักท่องเที่ยว”
มีโครงสร้างเป็นทางการและใช้คำเชื่อมอย่างเป็นระบบมากกว่า แต่ไม่ควรใช้ความแตกต่างนี้ฟันธงว่าแบบแรกเขียนโดยมนุษย์และแบบหลังเขียนโดย AI เพราะ AI สามารถสร้างภาษาพูดได้ และมนุษย์ก็สามารถเขียนด้วยสำนวนที่เป็นทางการและมีรูปแบบสม่ำเสมอได้เช่นกัน
นอกจากนี้ ระบบอาจพิจารณารูปแบบการใช้คำและโครงสร้างที่เกิดซ้ำ เช่น การใช้วลี “ไม่ใช่แค่…แต่ยัง…” การเรียงลำดับเนื้อหาแบบเกริ่นนำ อธิบาย และสรุป หรือการใช้คำเชื่อมอย่าง “นอกจากนี้” “อย่างไรก็ตาม” และ “ยิ่งไปกว่านั้น” บ่อยครั้ง แต่ลักษณะเหล่านี้ไม่ใช่หลักฐานเฉพาะของ AI เพราะเป็นรูปแบบที่พบได้ทั่วไปในงานเขียนที่ผ่านการเรียบเรียงมาอย่างดี การตรวจจับจึงควรพิจารณาคุณสมบัติหลายอย่างร่วมกัน และต้องระวังเป็นพิเศษเมื่อใช้กับภาษาไทยหรือข้อความที่มีลักษณะเฉพาะทาง เพราะผลการตรวจจับอาจแตกต่างกันตามภาษาและข้อมูลที่ระบบเคยเรียนรู้มา
ใช้ Machine Learning วิเคราะห์รูปแบบข้อความ
วิธีที่สามคือการใช้ Machine Learning หรือการเรียนรู้ของเครื่อง เพื่อฝึกระบบให้แยกแยะความแตกต่างระหว่างข้อความที่มนุษย์เขียนกับข้อความที่สร้างโดย AI วิธีนี้แตกต่างจากการตรวจสอบ Perplexity เพียงค่าเดียว เพราะระบบสามารถเรียนรู้จากตัวอย่างข้อความจำนวนมาก ทั้งงานเขียนของมนุษย์และข้อความที่สร้างจากโมเดล AI หลายประเภท แล้วนำคุณสมบัติที่เรียนรู้ได้มาประกอบการจำแนก เมื่อได้รับข้อความใหม่ ระบบจะประเมินว่าลักษณะของข้อความนั้นใกล้เคียงกับกลุ่มใดมากกว่า ทั้งนี้ ผู้พัฒนาแต่ละรายอาจใช้ข้อมูลฝึก วิธีวิเคราะห์ และเกณฑ์การตัดสินที่แตกต่างกัน จึงไม่สามารถสรุปได้ว่า AI Detector ทุกตัวทำงานด้วยหลักการเดียวกัน
ตัวอย่างเช่น ระบบอาจเรียนรู้ว่าข้อความจากชุดข้อมูลที่ใช้ฝึกมีรูปแบบการเลือกคำ โครงสร้างประโยค หรือคุณสมบัติทางภาษาบางอย่างที่แตกต่างกัน เมื่อนำข้อความใหม่มาตรวจ ระบบจะนำรูปแบบเหล่านั้นมาใช้ประกอบการจำแนก แต่การเรียนรู้จากตัวอย่างก็มีข้อจำกัด เพราะหากข้อความใหม่มาจากโมเดล AI ที่แตกต่างจากข้อมูลฝึกมาก หรือเป็นงานเขียนเฉพาะทางที่ระบบไม่คุ้นเคย ผลลัพธ์ก็อาจคลาดเคลื่อนได้ นอกจากนี้ หากมนุษย์นำข้อความ AI มาแก้ไข แปลภาษา หรือเรียบเรียงใหม่ คุณสมบัติของข้อความก็อาจเปลี่ยนไปจนทำให้ระบบจำแนกได้ยากขึ้น
ข้อจำกัดนี้เห็นได้จากเครื่องมือ AI Classifier ที่ OpenAI เคยเปิดให้ใช้งานในปี 2023 ซึ่งบริษัทระบุว่าเครื่องมือสามารถระบุข้อความภาษาอังกฤษที่สร้างด้วย AI ได้ถูกต้องเพียง 26% ในชุดทดสอบหนึ่ง และระบุข้อความที่มนุษย์เขียนผิดว่าเป็นข้อความจาก AI อยู่ 9% ของข้อความที่มนุษย์เขียนในชุดทดสอบนั้น ก่อนที่ OpenAI จะยุติการให้บริการเครื่องมือดังกล่าวในเดือนกรกฎาคมปีเดียวกัน เนื่องจากมีความแม่นยำต่ำ ตัวเลขนี้เป็นผลทดสอบของเครื่องมือรุ่นเก่า ไม่ใช่ผลประเมิน AI Detector ทุกตัวในปัจจุบัน แต่สะท้อนให้เห็นว่า แม้จะใช้ Machine Learning ก็ยังมีโอกาสจำแนกผิดได้ จึงไม่ควรนำผลตรวจเพียงอย่างเดียวไปใช้กล่าวหาหรือตัดสินผลงานของใคร
ตรวจจับลายน้ำดิจิทัล หรือ Watermark
อีกวิธีหนึ่งคือการฝังลายน้ำดิจิทัลลงในคอนเทนต์ตั้งแต่ขั้นตอนการสร้าง แทนที่จะพยายามตรวจสอบย้อนหลังจากรูปแบบของข้อความเพียงอย่างเดียว แนวคิดนี้คือการทำให้คอนเทนต์มีสัญญาณบางอย่างที่ระบบตรวจจับสามารถค้นหาได้ภายหลัง โดยลายน้ำไม่จำเป็นต้องเป็นข้อความ โลโก้ หรือสัญลักษณ์ที่มองเห็นด้วยตาเปล่าเสมอไป สำหรับข้อความ AI สามารถฝังสัญญาณทางสถิติลงในรูปแบบการเลือกคำหรือส่วนของคำได้ เมื่อมีข้อความยาวเพียงพอ ระบบตรวจจับที่รองรับก็จะวิเคราะห์ว่าข้อความนั้นมีรูปแบบตรงกับลายน้ำที่กำหนดไว้หรือไม่
ตัวอย่างที่น่าสนใจคือ textGrain ซึ่ง OpenAI ประกาศแนวทางเมื่อวันที่ 5 ตุลาคม 2026 โดยเป็นเทคโนโลยีลายน้ำข้อความที่ปรับรูปแบบทางสถิติในการสุ่มเลือกคำของโมเดล เพื่อให้ระบบตรวจจับสามารถค้นหาสัญญาณดังกล่าวได้ โดยไม่ต้องเพิ่มตัวอักษรลับหรือช่องว่างที่มองไม่เห็นลงไปในข้อความ OpenAI ระบุว่าได้เริ่มเปิดให้ลูกค้า API ทั่วโลกเลือกใช้กับโมเดลที่รองรับ โดยปิดไว้เป็นค่าเริ่มต้น และมีแผนทยอยเพิ่มลายน้ำให้ข้อความจาก ChatGPT และ Codex ที่เข้าเกณฑ์ในสหภาพยุโรปในช่วงหลายสัปดาห์หลังการประกาศ พร้อมเปิดรับคำขอเข้าถึงเครื่องมือตรวจจับจากนักวิจัยและองค์กรผู้เชี่ยวชาญที่ได้รับอนุมัติ ดังนั้น จึงไม่ควรกล่าวว่า ChatGPT ใส่ลายน้ำให้ข้อความทุกชิ้นทั่วโลกแล้ว
อย่างไรก็ตาม ลายน้ำก็ไม่ได้รับประกันว่าจะตรวจพบได้ทุกครั้ง เพราะข้อความสั้นหรือข้อความที่มีข้อจำกัดด้านรูปแบบอาจตรวจจับได้ยาก และระบบอาจเกิดทั้งผลบวกลวง คือระบุว่าพบลายน้ำทั้งที่ไม่มีจริง และผลลบลวง คือไม่พบลายน้ำทั้งที่มีอยู่ นอกจากนี้ ลายน้ำของผู้พัฒนารายหนึ่งไม่ได้หมายความว่าจะตรวจจับข้อความจาก AI ทุกค่ายได้ด้วย ข้อความที่ผ่านการแก้ไขมาก หรือข้อความที่ไม่ได้สร้างด้วยโมเดลซึ่งฝังลายน้ำที่ระบบรองรับ ก็อาจไม่สามารถตรวจพบได้เช่นกัน ลายน้ำจึงเป็นหลักฐานประกอบเกี่ยวกับที่มาของข้อความ แต่ไม่ใช่เครื่องมือที่ใช้พิสูจน์ตัวผู้เขียนหรือรับรองความถูกต้องของเนื้อหาได้โดยลำพัง
ตรวจสอบข้อมูลแหล่งที่มาของคอนเทนต์ และการติดป้าย AI Content
นอกเหนือจากการวิเคราะห์ข้อความและการฝังลายน้ำแล้ว อีกแนวทางหนึ่งคือการตรวจสอบข้อมูลแหล่งที่มาของไฟล์ หรือ Content Provenance ซึ่งอาจประกอบด้วยข้อมูลว่าไฟล์ถูกสร้างด้วยเครื่องมือใด ผ่านการแก้ไขอะไรบ้าง หรือมีสัญญาณทางเทคนิคที่เกี่ยวข้องกับ AI หรือไม่ สำหรับรูปภาพและวิดีโอ ข้อมูลดังกล่าวอาจอยู่ในเมทาดาทา หรือใช้มาตรฐานอย่าง Content Credentials ของ C2PA ซึ่งช่วยบันทึกข้อมูลเกี่ยวกับที่มาและประวัติการแก้ไขของสื่อได้ วิธีนี้ต่างจากการตรวจจับข้อความทั่วไป เพราะระบบไม่ได้พิจารณาเพียงว่าสำนวนการเขียนดูเหมือน AI หรือไม่ แต่ตรวจสอบข้อมูลที่เกี่ยวข้องกับตัวไฟล์ด้วย อย่างไรก็ตาม เมทาดาทาอาจสูญหายเมื่อมีการแปลงไฟล์หรืออัปโหลดผ่านบางบริการ จึงไม่สามารถรับประกันได้ว่าทุกไฟล์จะมีข้อมูลครบถ้วน
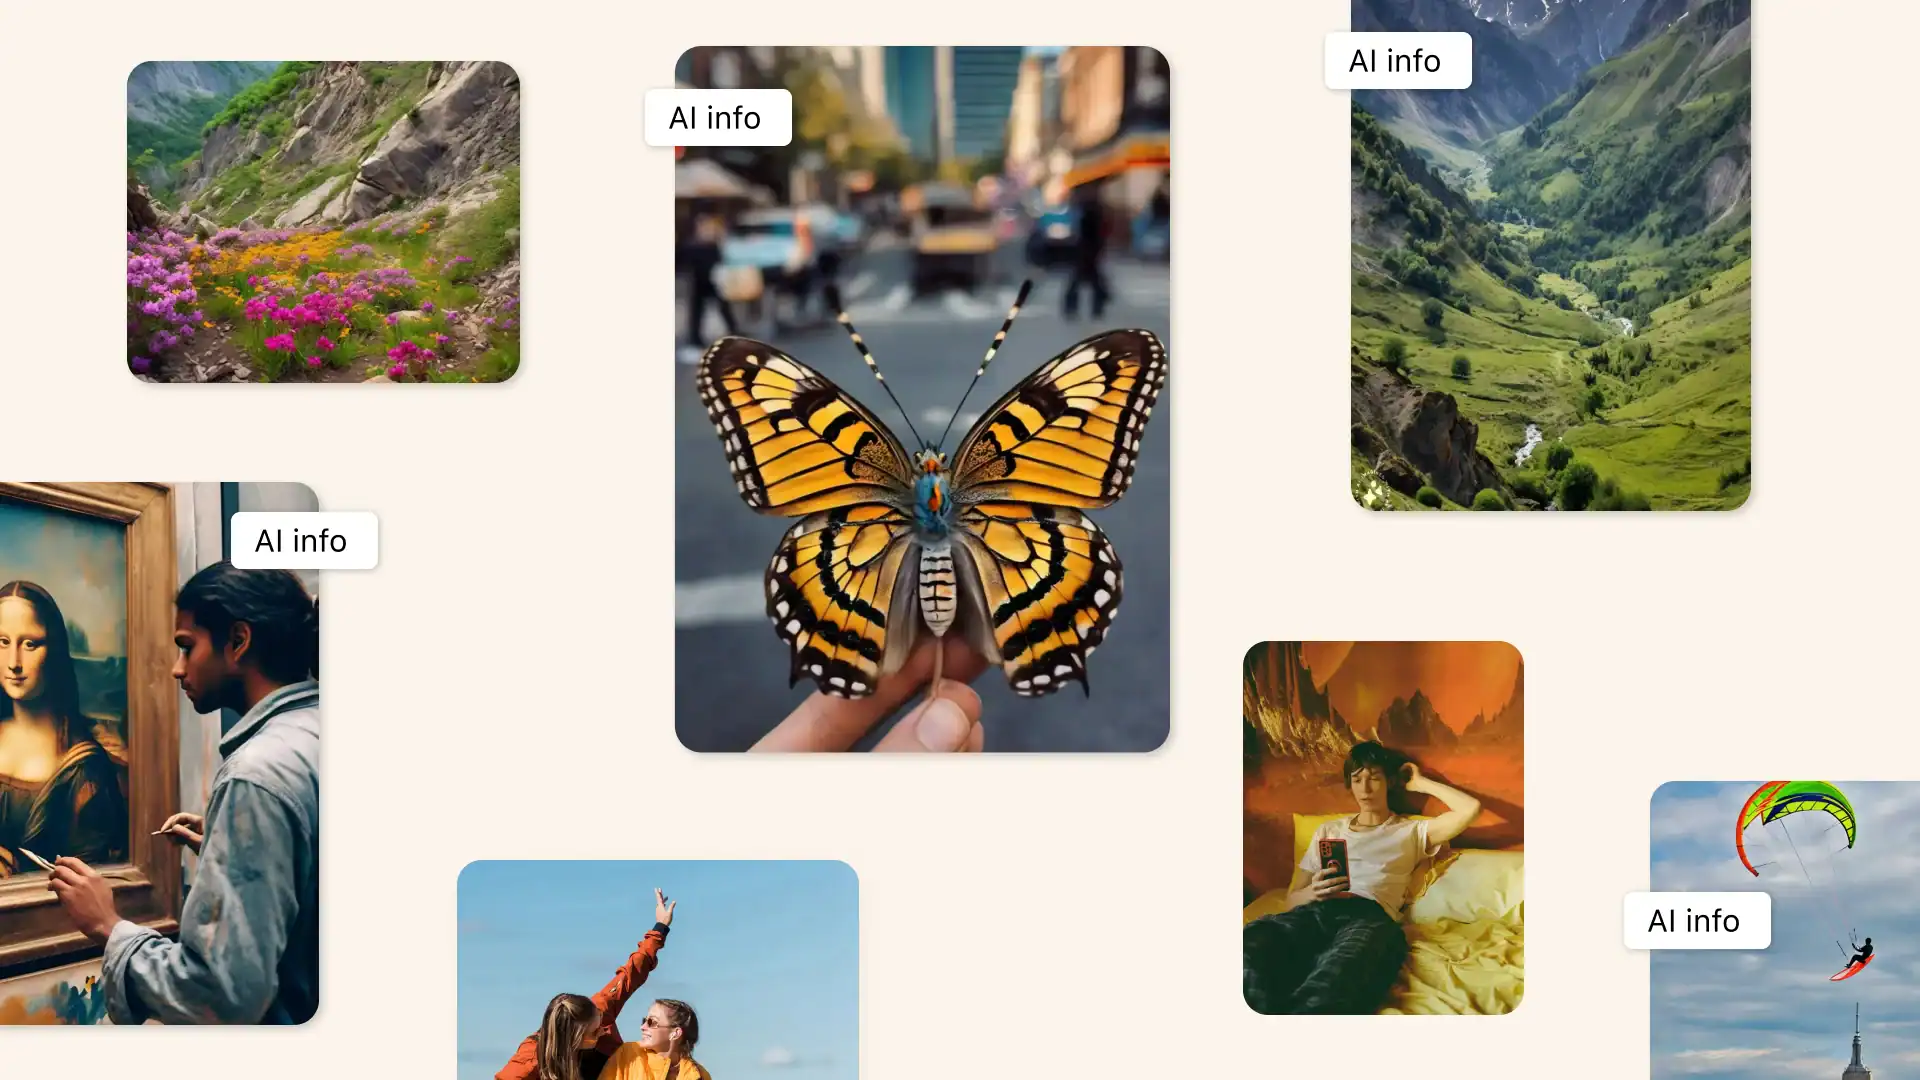
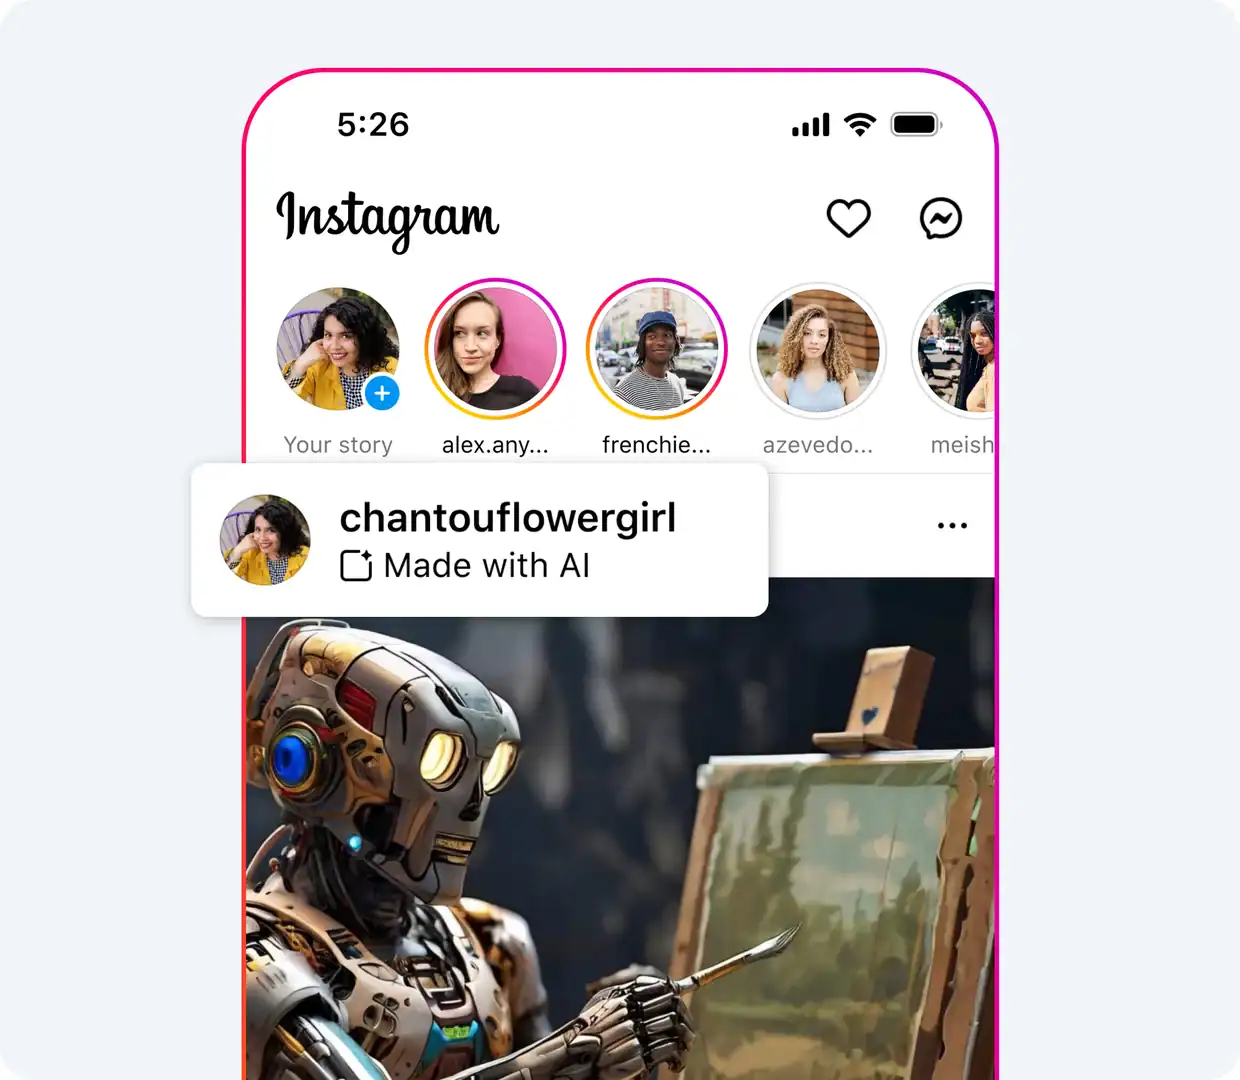
สำหรับ Facebook, Instagram และ Threads นั้น Meta ระบุว่าใช้สัญญาณทางเทคนิคที่เป็นมาตรฐานร่วมกันในอุตสาหกรรมเพื่อช่วยระบุคอนเทนต์ที่สร้างด้วย AI โดยเฉพาะรูปภาพ วิดีโอ และเสียง รวมถึงเปิดให้ผู้ใช้เปิดเผยว่าเนื้อหาที่โพสต์สร้างด้วย AI ด้วย หากระบบตรวจพบสัญญาณที่เกี่ยวข้อง ก็อาจแสดงป้าย AI info เพื่อให้ผู้ชมทราบข้อมูลเพิ่มเติมเกี่ยวกับที่มาของคอนเทนต์ แต่การติดป้ายไม่ได้เกิดจากลายน้ำเพียงวิธีเดียว และไม่ได้หมายความว่าระบบจะตรวจพบคอนเทนต์ AI ทุกชิ้นเสมอไป Meta ยังระบุด้วยว่า หากเนื้อหาผ่านการแก้ไขด้วย AI เพียงบางส่วน ป้ายข้อมูลอาจแสดงในเมนูของโพสต์ แทนการแสดงป้ายเด่นบนเนื้อหาโดยตรง ทั้งนี้ขึ้นอยู่กับลักษณะการใช้งาน AI ที่ระบบตรวจพบ
อีกเรื่องที่ควรแยกให้ออกคือ การตรวจจับว่าเนื้อหาสร้างด้วย AI ไม่ใช่เรื่องเดียวกับการตัดสินว่าเนื้อหานั้นผิดกฎหรือควรถูกลดการมองเห็น เพราะการใช้ AI ไม่ได้หมายความว่าเนื้อหาจะเป็นอันตรายหรือผิดนโยบายโดยอัตโนมัติ Meta ระบุว่าคอนเทนต์ที่สร้างด้วย AI สามารถคงอยู่บนแพลตฟอร์มพร้อมป้ายข้อมูลได้ หากไม่ละเมิดกฎอื่นของแพลตฟอร์ม แต่เนื้อหาที่สร้างโดยมนุษย์หรือ AI ซึ่งละเมิดกฎชุมชนก็ยังอาจถูกจำกัดหรือลบได้เช่นกัน ดังนั้น จึงไม่ควรสรุปว่าเพียงติดป้าย AI Content แล้วจะไม่ถูกลด Reach หรือไม่กระทบต่อการสร้างรายได้ เพราะผลลัพธ์ขึ้นอยู่กับนโยบายและเงื่อนไขของแต่ละแพลตฟอร์ม ไม่ใช่เพียงการเปิดเผยว่าใช้ AI หรือไม่
สรุป: AI Detector ไม่ได้มีวิธีตรวจจับเพียงแบบเดียว
การตรวจจับคอนเทนต์ AI อาจใช้ตั้งแต่การวิเคราะห์ความน่าจะเป็นของคำและความหลากหลายของประโยค การใช้ Machine Learning จำแนกรูปแบบ ไปจนถึงการตรวจลายน้ำและข้อมูลแหล่งที่มาของไฟล์ แต่ทุกวิธีก็มีข้อจำกัดแตกต่างกันไป
สิ่งสำคัญคือ ผลตรวจจับ AI เป็นเพียงข้อมูลประกอบ ไม่ใช่คำตัดสินที่ถูกต้อง 100% การระบุว่าเนื้อหาชิ้นหนึ่งสร้างด้วย AI จึงควรพิจารณาหลักฐานอื่นร่วมด้วย โดยเฉพาะเมื่อผลลัพธ์นั้นอาจส่งผลต่อชื่อเสียง การเรียน การทำงาน หรือรายได้ของผู้สร้างคอนเทนต์
อ้างอิง openai.com help.openai.com openai.com link.springer.com about.fb.com และ cover iT24Hrs
และข่าวอื่นๆเพิ่มเติมได้ที่ it24hrs.com
AI จับผิดคอนเทนต์ที่สร้างด้วย AI ได้ยังไง?
อย่าลืมกดติดตามอัพเดตข่าวสาร ทิปเทคนิคดีๆกันนะคะ Please follow us
Youtube it24hrs
Twitter it24hrs
Tiktok it24hrs
facebook it24hrs
ติดต่อโฆษณา [email protected] โทร 080234502